推理成本
-
英伟达发布全栈协同设计,提升AI推理每美元吞吐量
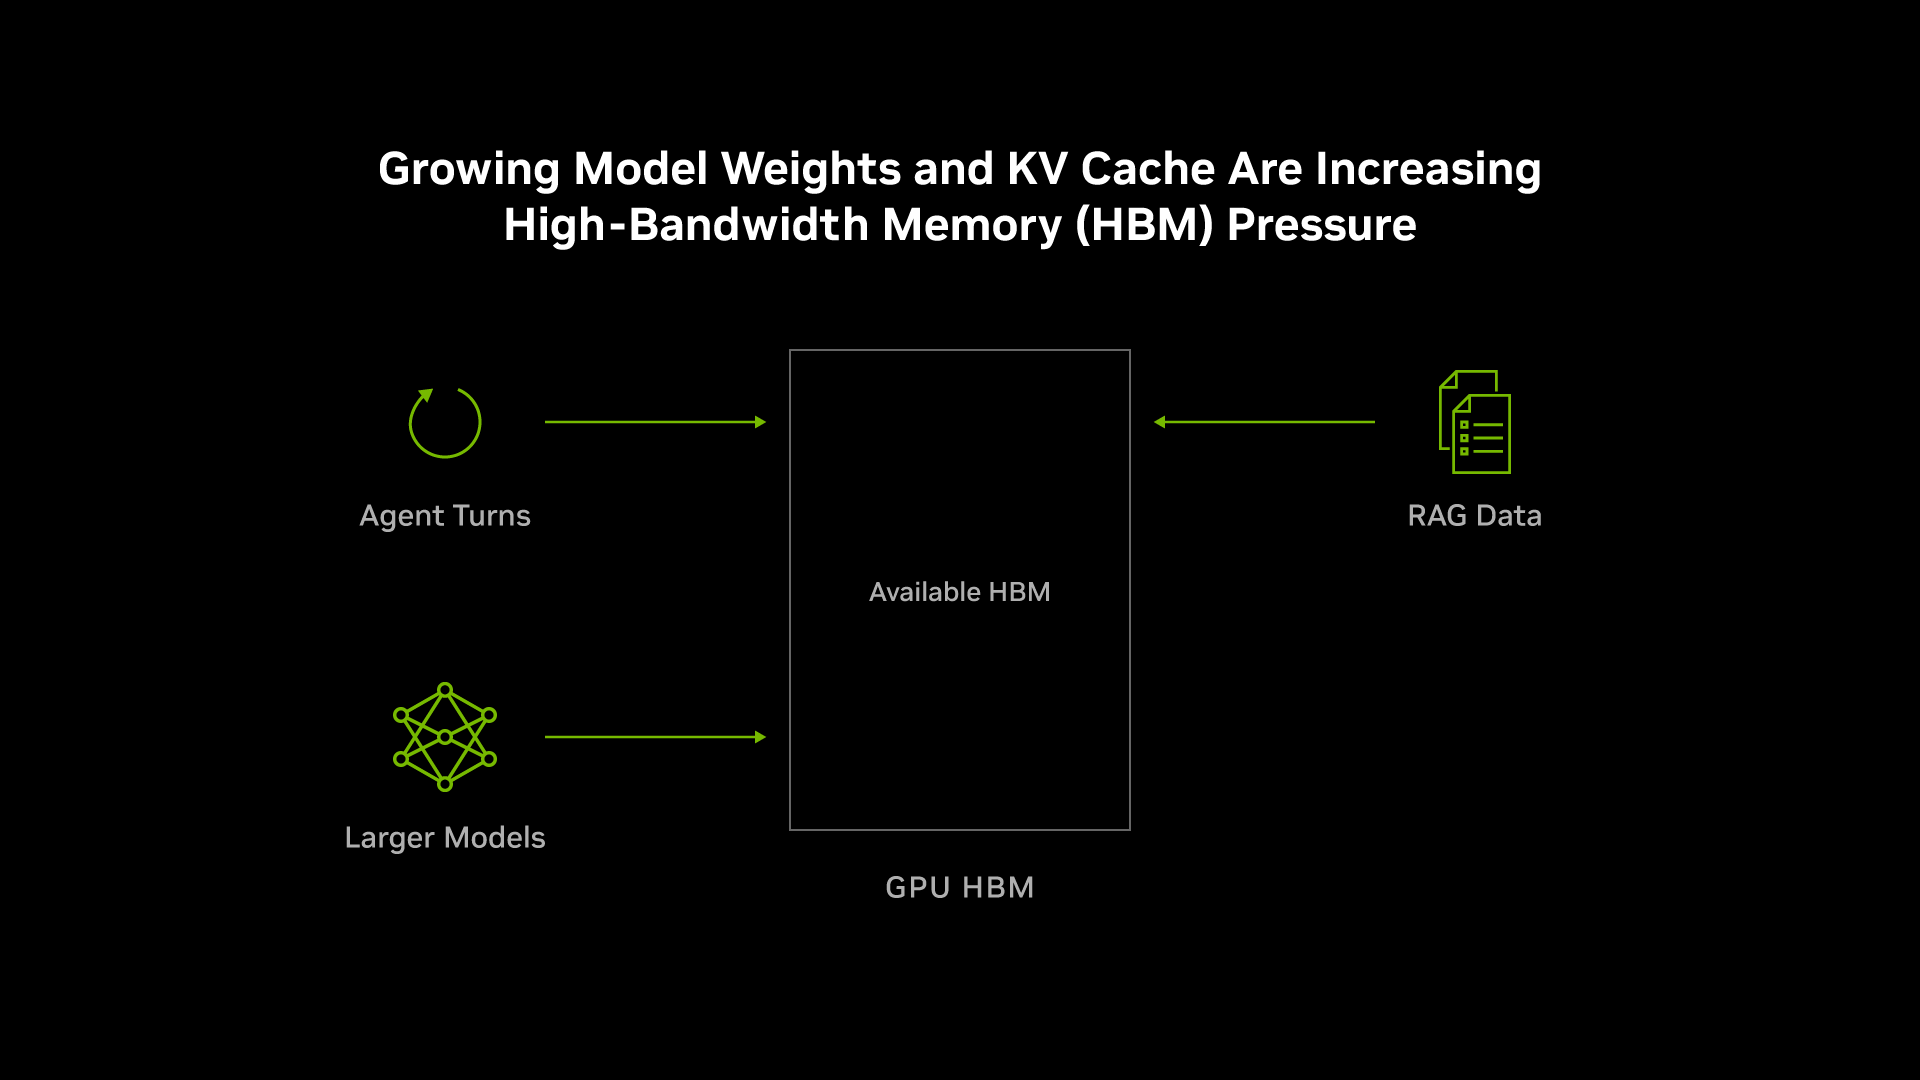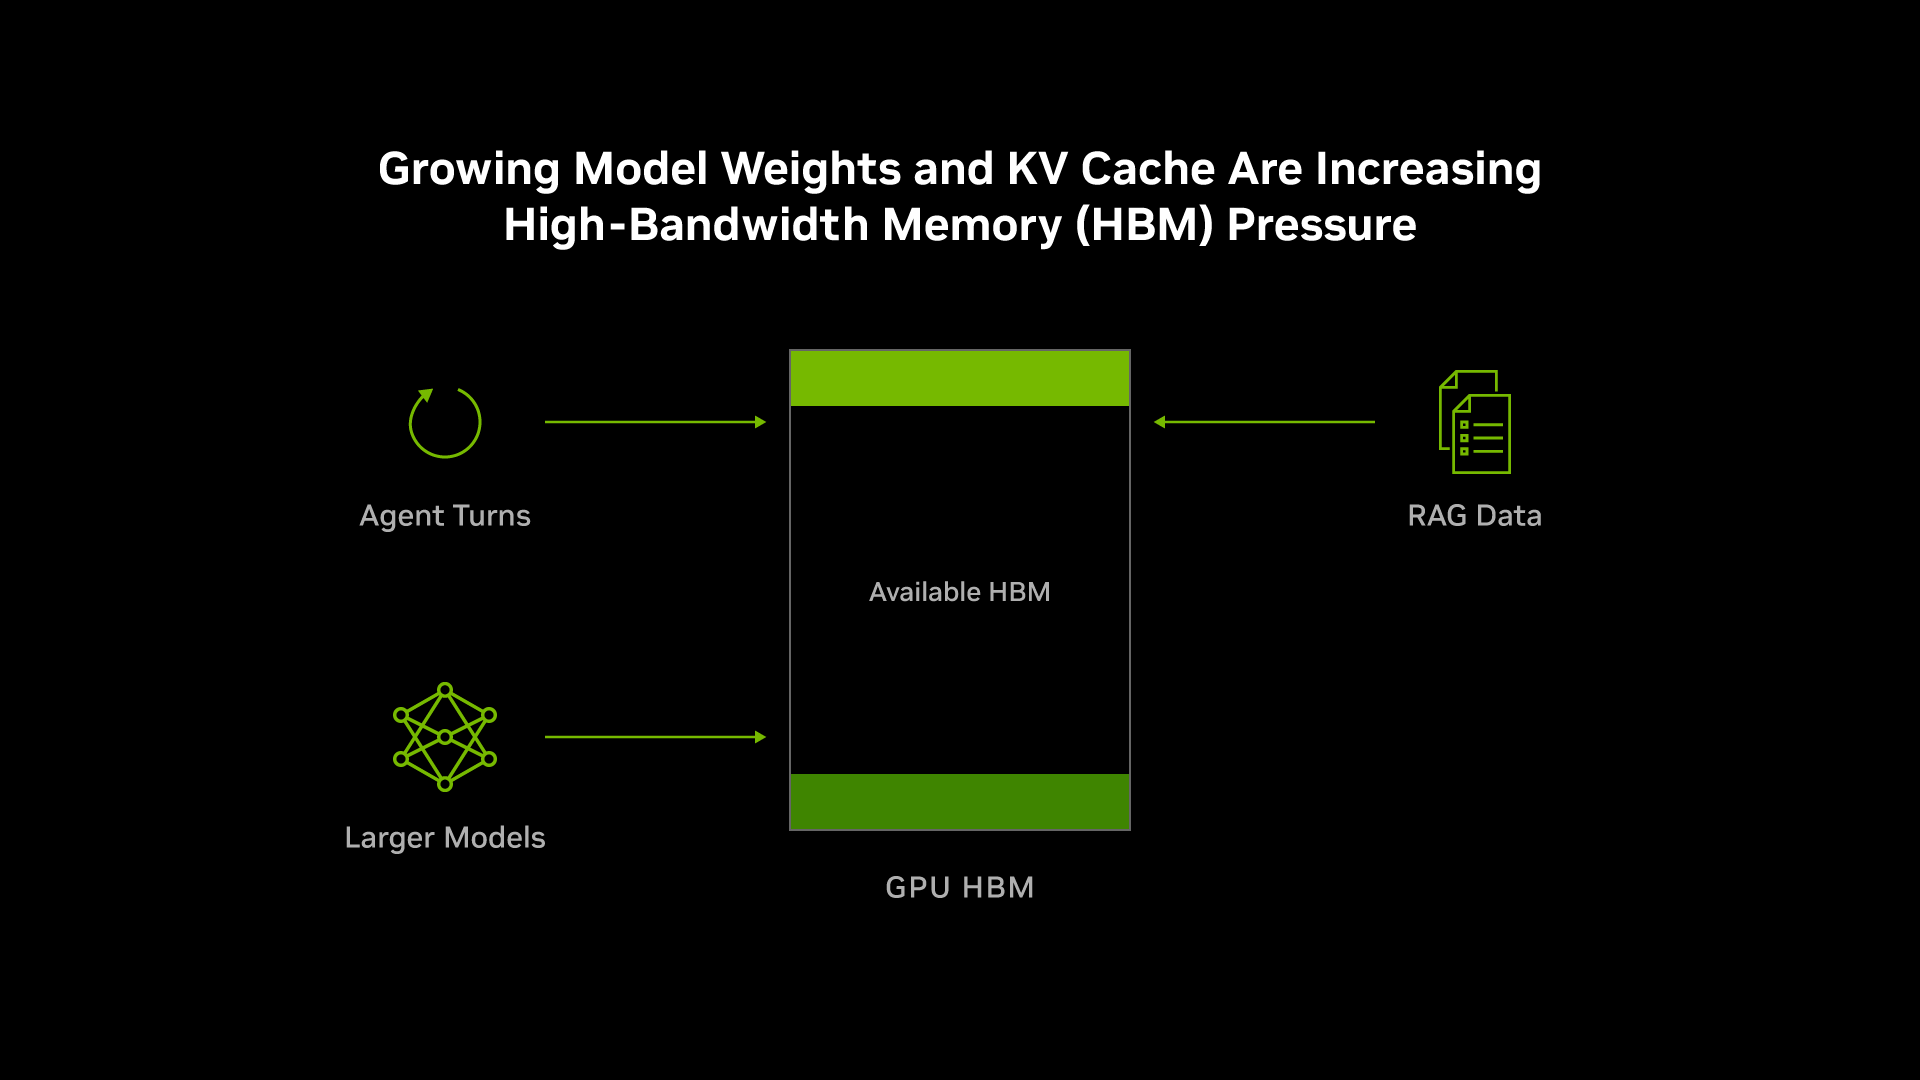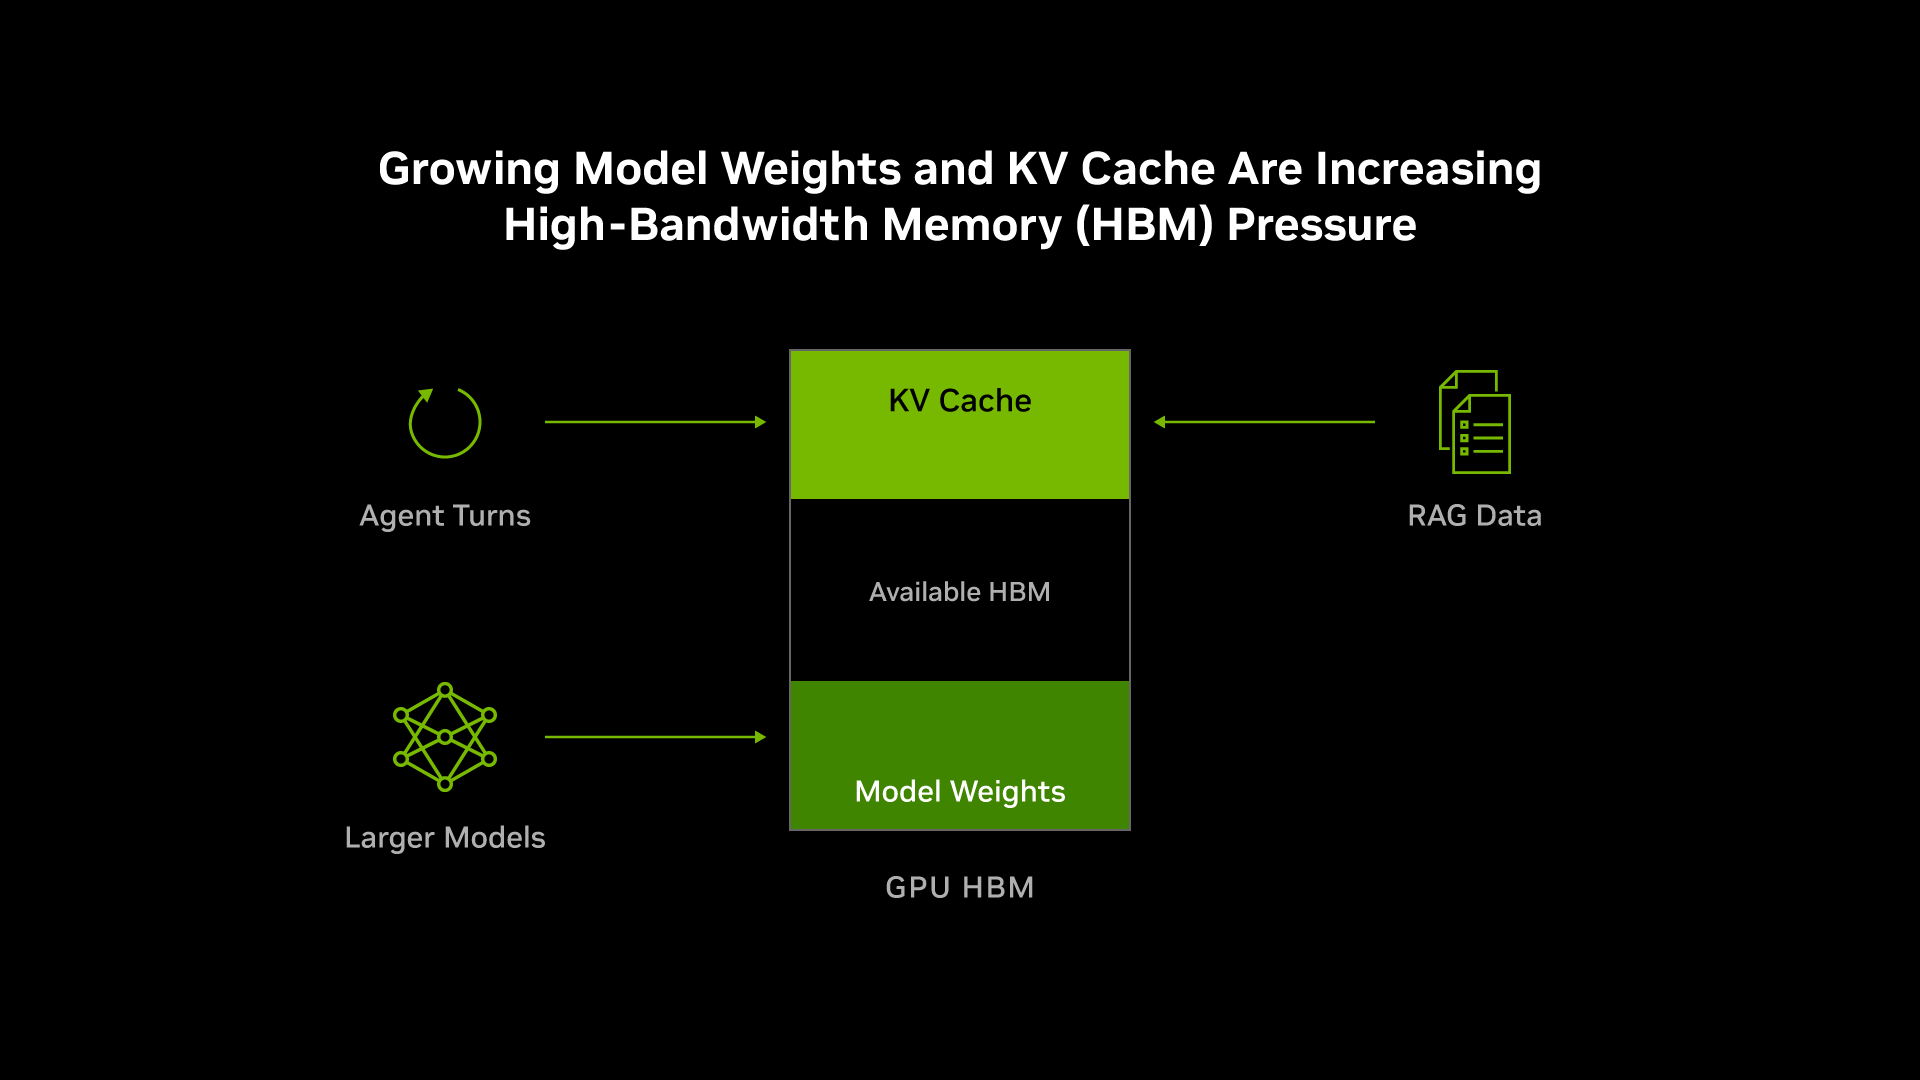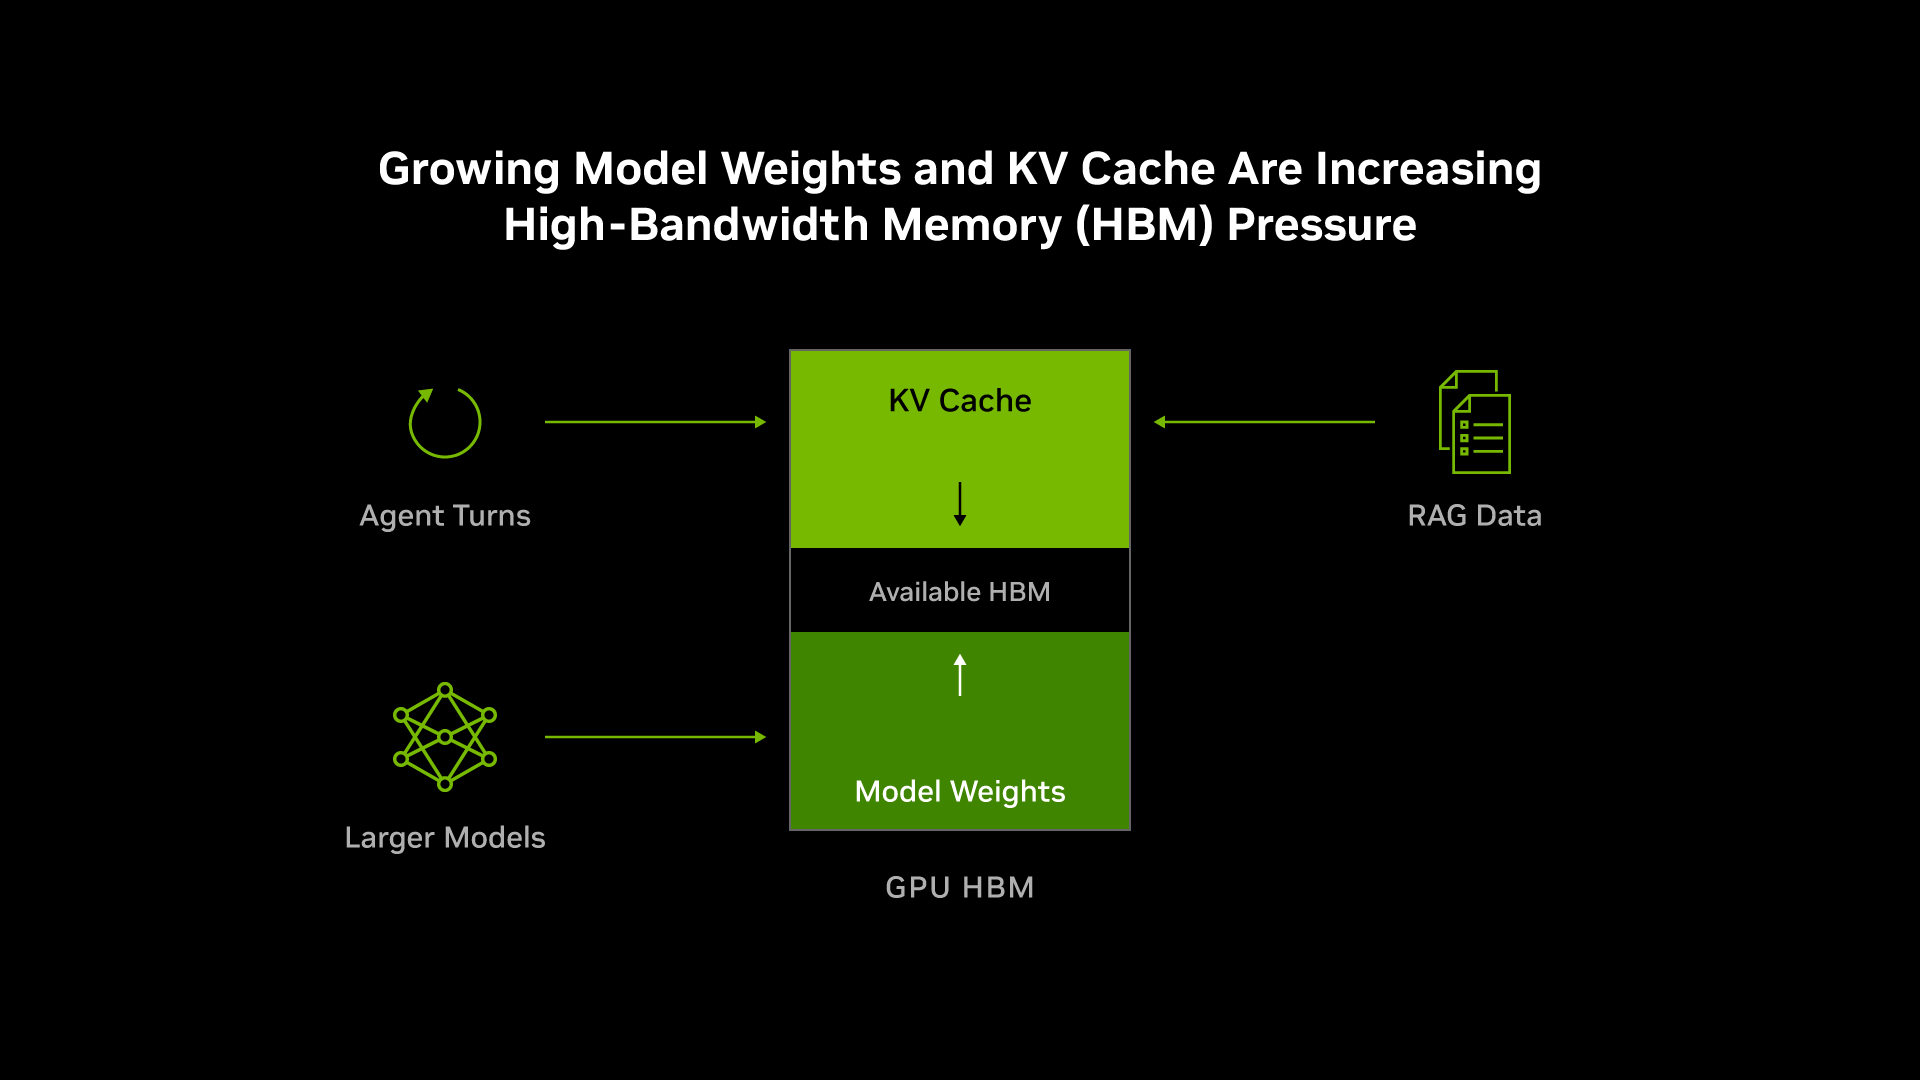
英伟达在11月5日发布技术解读,聚焦AI推理中HBM资源压力。随着大模型参数规模及智能体应用扩展,GPU显存需承载模型权重与KV缓存。部分场景处理多达300万个token,加上检索增强生成(RAG)引……
英伟达在11月5日发布技术解读,聚焦AI推理中HBM资源压力。随着大模型参数规模及智能体应用扩展,GPU显存需承载模型权重与KV缓存。部分场景处理多达300万个token,加上检索增强生成(RAG)引……