一句话
-
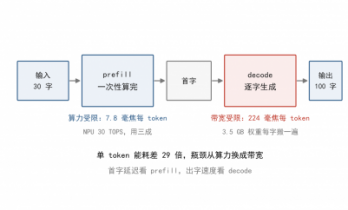
一句话回复的功耗,端侧模型怎么分成两段
端侧 7B 模型答一句话,两个阶段的单 token 能耗差 29 倍。读 30 个字的输入用掉 0.23 焦,写 100 个字的回复用掉 22.4 焦。把优化预算押在算力上会打偏,回复阶段的瓶颈是内存带宽,不是 NPU。 一句话答…
端侧 7B 模型答一句话,两个阶段的单 token 能耗差 29 倍。读 30 个字的输入用掉 0.23 焦,写 100 个字的回复用掉 22.4 焦。把优化预算押在算力上会打偏,回复阶段的瓶颈是内存带宽,不是 NPU。 一句话答…